


Migra código con el traductor de SQL por lotes
En este documento, se describe cómo usar el traductor de SQL por lotes en BigQuery para traducir secuencias de comandos escritas en otros dialectos de SQL a consultas de GoogleSQL. Puedes enviar y revisar los resultados de un trabajo de traducción desde la consola de Google Cloud o desde la línea de comandos.
Para obtener una lista de los dialectos de SQL que admite este traductor de SQL, consulta Dialectos de SQL admitidos.
Para obtener una lista de las ubicaciones de procesamiento compatibles, consulta Ubicaciones.
Antes de comenzar
Antes de enviar un trabajo de traducción, completa los siguientes pasos.
Habilita las traducciones de SQL
Habilita la API requerida y obtén los permisos necesarios para usar un traductor de SQL de BigQuery. Para obtener más información, consulta Cómo habilitar las traducciones de SQL.
Permisos necesarios
Para obtener los permisos que
necesitas para crear trabajos de traducción con el traductor interactivo, la API de Translation o el traductor de SQL por lotes,
pídele a tu administrador que te otorgue los
siguientes roles de IAM en el recurso parent:
-
Visualización y supervisión de trabajos de migración:
Visualizador de MigrationWorkflow (
roles/bigquerymigration.viewer) -
Envío de trabajos de migración:
Editor de MigrationWorkflow (
roles/bigquerymigration.editor) -
Accede a los buckets y archivos de Cloud Storage:
Administrador de objetos de Storage (
roles/storage.objectAdmin): En el bucket de Cloud Storage de origen y destino.
Para obtener más información sobre cómo otorgar roles, consulta Administra el acceso a proyectos, carpetas y organizaciones.
Estos roles predefinidos contienen los permisos necesarios para crear trabajos de traducción con el traductor interactivo, la API de Translation o el traductor de SQL por lotes. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para crear trabajos de traducción con el traductor interactivo, la API de Translation o el traductor de SQL por lotes:
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.workflows.list -
bigquerymigration.workflows.delete -
bigquerymigration.subtasks.get -
bigquerymigration.subtasks.list -
storage.objects.get -
storage.objects.list -
storage.objects.create
También puedes obtener estos permisos con roles personalizados o con otros roles predefinidos.
Recopila los archivos de origen
Los archivos de origen deben ser archivos de texto que contengan SQL válido para el dialecto de origen. Los archivos de origen también pueden incluir comentarios. Haz todo lo posible para asegurarte de que SQL sea válido a través del uso de los métodos disponibles para ti.
Crea archivos de metadatos
Para ayudar a que el servicio genere resultados de traducción más precisos, te recomendamos que proporciones archivos de metadatos. Sin embargo, esto no es obligatorio.
Puedes usar la herramienta de extracción de línea de comandos dwh-migration-dumper para generar la información de metadatos. Después de preparar los archivos de metadatos, puedes incluirlos junto con los archivos de origen en la carpeta de origen de la traducción. El traductor los detecta automáticamente y los aprovecha para traducir archivos de origen; no necesitas establecer ninguna configuración adicional para habilitar esto.
Si deseas generar información de metadatos a través de la herramienta dwh-migration-dumper, consulta Genera metadatos para la traducción.
Crea archivos YAML de configuración
De forma opcional, puedes crear y usar archivos YAML de configuración de configuración para personalizar tus traducciones por lotes. Estos archivos se pueden usar para transformar el resultado de la traducción de varias maneras. Por ejemplo, puedes crear un archivo YAML de configuración para cambiar el caso de un objeto SQL durante la traducción.
Para usar un archivo YAML de configuración, súbelo al bucket de Cloud Storage que contiene los archivos de origen.
Sube archivos de entrada a Cloud Storage
Sube a Cloud Storage los archivos de origen que contienen las consultas y los scripts que deseas traducir. También puedes subir cualquier archivo de metadatos o archivos YAML de configuración al mismo bucket de Cloud Storage y directorio que contiene los archivos de origen. Para obtener más información sobre la creación de buckets y la carga de archivos a Cloud Storage, consulta Crea buckets y Sube objetos desde un sistema de archivos.
Elige cómo enviar el trabajo de traducción
Tienes dos opciones para enviar un trabajo de traducción por lotes:
Google Cloud Consola: Configura y envía un trabajo a través de una interfaz de usuario.
Herramientas de línea de comandos: Describe el trabajo en un archivo de configuración de traducción y envíalo con Google Cloud CLI o la herramienta de línea de comandos de bq.
Ambas opciones requieren que subas tus archivos fuente a Cloud Storage y ambas crean el mismo tipo de trabajo de traducción. Un trabajo que envías desde la línea de comandos sigue apareciendo en la lista de trabajos de traducción en la consola deGoogle Cloud .
Envía un trabajo de traducción
Usa una de las siguientes opciones para iniciar un trabajo de traducción y ver su progreso. Para revisar los resultados después, consulta Explora el resultado de la traducción.
Console
En estos pasos, se da por sentado que subiste archivos de origen a un bucket de Cloud Storage.
Para usar la Google Cloud consola y enviar un trabajo de traducción por lotes, sigue estos pasos:
En la consola de Google Cloud , ve a la página Traducción de SQL.
En el panel Traducción de SQL, haz clic en Iniciar traducción.
En Configuración de traducción, ingresa lo siguiente:
- En Nombre visible, ingresa un nombre para el trabajo de traducción. El nombre puede contener letras, números o guiones bajos.
- En Ubicación de procesamiento, selecciona la ubicación en la que deseas que se ejecute el trabajo de traducción. Por ejemplo, si estás en Europa y no quieres que tus datos pasen ningún límite de ubicación, selecciona la región
eu. El trabajo de traducción tiene un mejor rendimiento cuando eliges la misma ubicación que tu bucket de archivos de origen. - En Dialecto de origen, selecciona el dialecto de SQL que deseas traducir.
- En Dialecto de destino, selecciona GoogleSQL.
Haz clic en Siguiente.
En Detalles de la ubicación del archivo, especifica las rutas de Cloud Storage que se usarán para la entrada y salida de la traducción. Puedes ingresar las rutas en el formato
bucket_name/folder_name/o usar la opción Explorar para navegar a una carpeta.- En Ubicación del directorio de salida, especifica una ruta de acceso a la carpeta de Cloud Storage de destino para los archivos traducidos. Este directorio sirve como directorio raíz para todos los resultados de la traducción.
- Elige una o más ubicaciones de directorios de entrada que contengan la ruta a los archivos SQL que se traducirán.
- Si es necesario, a cada directorio de entrada se le puede asignar de forma opcional un nombre de subdirectorio de salida debajo del directorio de salida raíz.
Haz clic en Siguiente.
Selecciona los parámetros de configuración opcionales que necesites para personalizar los metadatos y los resultados de traducción adicionales.
Opcional: Para personalizar aún más el comportamiento de la traducción, crea archivos YAML de configuración y colócalos en el bucket de entrada de Cloud Storage. Estos archivos se pueden usar para cambiar el nombre de los objetos, habilitar optimizaciones, mejorar las traducciones con Gemini y mucho más. Para obtener más información sobre los archivos YAML de configuración, consulta Crea un archivo YAML de configuración.
Haz clic en Crear para iniciar el trabajo de traducción.
Después de crear el trabajo de traducción, puedes ver su estado en la lista de trabajos de traducción.
bq
Para usar gcloud CLI o la herramienta de línea de comandos de bq para enviar un trabajo de traducción por lotes, sigue estos pasos.
En estos pasos, se da por sentado que subiste archivos de origen a un bucket de Cloud Storage.
Crea un archivo de configuración de traducción
Un archivo de configuración de traducción define la ruta de acceso a los archivos fuente, el destino de salida y los dialectos de origen y destino de tu traducción. Puedes escribir este archivo en formato YAML o JSON.
En el siguiente ejemplo, se muestra un archivo YAML de configuración de traducción para una traducción de Teradata a BigQuery:
tasks:
  translation_task:
    type: Teradata2BigQuery_Translation
    translationDetails:
      sourceTargetMapping:
      - sourceSpec:
          baseUri: gs://bq-translations/input
        targetSpec:
          relativePath: output
      targetBaseUri: gs://bq-translations
      targetTypes:
      - sql
      sourceEnvironment:
        defaultDatabase: default_db
        schemaSearchPath:
        - foo
En el siguiente ejemplo, se muestra un archivo JSON de configuración de la traducción para una traducción de Teradata a BigQuery:
{
  "tasks": {
    "translation_task": {
      "type": "Teradata2BigQuery_Translation",
      "translationDetails": {
        "sourceTargetMapping": [
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 1",
                "relativePath": "my_input_1"
              },
              "encoding": "UTF-8"
            }
          },
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 2",
                "relativePath": "my_input_2"
              },
              "encoding": "UTF-8"
            }
          }
        ],
        "targetReturnLiterals": [
          "sql/my_input_1",
          "sql/my_input_2"
        ]
      }
    }
  }
}
Envía el trabajo con Google Cloud CLI
Para crear un trabajo de traducción y ejecutar el flujo de trabajo, usa el siguiente comando:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE
Para crear y ejecutar el flujo de trabajo, y volver de inmediato con un vínculo al flujo de trabajo, agrega la marca --async:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE --async
Para enumerar tus trabajos de traducción, usa el siguiente comando:
gcloud bq migration-workflows list --location=LOCATION
Para ver los detalles de un trabajo de traducción específico, usa el siguiente comando:
gcloud bq migration-workflows describe projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Reemplaza lo siguiente:
LOCATION: Es la ubicación del proyecto Google Cloud que ejecuta este trabajo de traducción.CONFIG_FILE: Es la ruta de acceso a tu archivo de configuración de traducción.PROJECT_ID: Es el ID del proyecto Google Cloud que ejecuta este trabajo de traducción.WORKFLOW_ID: Es el ID del trabajo de traducción.
Envía el trabajo con la herramienta de línea de comandos de bq
Para ejecutar el trabajo de traducción, usa el siguiente comando:
bq mk --migration_workflow --location=LOCATION --config_file=CONFIG_FILE
Para enumerar todos tus trabajos de traducción, usa el siguiente comando:
bq ls --migration_workflow --location=LOCATION
Para ver los detalles de un trabajo de traducción específico, usa el siguiente comando:
bq show --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Para quitar un trabajo de traducción de la lista, usa el siguiente comando:
bq rm --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Reemplaza lo siguiente:
LOCATION: Es la ubicación del proyecto Google Cloud que ejecuta este trabajo de traducción.CONFIG_FILE: Es la ruta de acceso a tu archivo de configuración de traducción.PROJECT_ID: Es el ID del proyecto Google Cloud que ejecuta este trabajo de traducción.WORKFLOW_ID: Es el ID del trabajo de traducción.
Recupera los archivos de salida
El trabajo de traducción escribe sus resultados en el directorio de Cloud Storage que estableciste en el campo targetBaseUri del archivo de configuración de traducción. Este directorio de destino contiene los archivos traducidos, el informe de resumen de la traducción y los archivos de sugerencias de IA.
Para copiar el resultado en tu máquina local, usa el siguiente comando:
gcloud storage cp --recursive TARGET_URI LOCAL_DIRECTORY
Reemplaza lo siguiente:
TARGET_URI: Es el URI base de destino, comogs://my_data_bucket/teradata/output/.LOCAL_DIRECTORY: Es el directorio local que recibe los archivos.
Tu trabajo también aparece en la lista de trabajos de traducción en la consola deGoogle Cloud , aunque lo hayas enviado desde la línea de comandos. Para revisar la calidad del resultado de una traducción, consulta Explora el resultado de la traducción.
Explora el resultado de la traducción
Puedes revisar los resultados de un trabajo de traducción en la consola de Google Cloud , independientemente de si el trabajo se envió desde la línea de comandos o la consola de Google Cloud . El traductor de SQL por lotes genera los siguientes archivos en el destino especificado:
- Los archivos traducidos
- El informe de resumen de traducción en formato CSV
- Son los archivos de sugerencias de IA.
Salida de la consola deGoogle Cloud
Para ver los detalles del trabajo de traducción, sigue estos pasos:
En la consola de Google Cloud , ve a la página Traducción de SQL.
En la lista de trabajos de traducción, busca el trabajo del que deseas ver los detalles de la traducción. Luego, haz clic en el nombre del trabajo de traducción. Puedes ver una visualización de Sankey que ilustra la calidad general del trabajo, la cantidad de líneas de código de entrada (sin incluir las líneas en blanco ni los comentarios) y una lista de los problemas que ocurrieron durante el proceso de traducción. Debes priorizar las correcciones de izquierda a derecha. Los problemas en una etapa inicial pueden causar problemas adicionales en etapas posteriores.
Mantén el puntero sobre las barras de error o advertencia y revisa las sugerencias para determinar los próximos pasos para depurar el trabajo de traducción.
Selecciona la pestaña Resumen de registro para ver un resumen de los problemas de traducción, incluidas las categorías de problema, las acciones sugeridas y la frecuencia con la que ocurrió cada problema. Puedes hacer clic en las barras de visualización de Sankey para filtrar los problemas. También puedes seleccionar una categoría de problema para ver los mensajes de registro asociados con esa categoría de problema.
Selecciona la pestaña Mensajes de registro para ver más detalles sobre cada problema de traducción, incluida la categoría de problema, el mensaje de problema específico y un vínculo al archivo en el que se produjo el problema. Puedes hacer clic en las barras de visualización de Sankey para filtrar los problemas. Puedes seleccionar un problema en la pestaña Mensaje de registro para abrir la pestaña Código que muestra el archivo de entrada y salida si es aplicable.
Haz clic en la pestaña Detalles del trabajo para ver los detalles de la configuración del trabajo de traducción.
Informe de resumen
El informe de resumen es un archivo CSV que contiene una tabla de todos los mensajes de advertencia y error que se encontraron durante el trabajo de traducción.
Para ver el archivo de resumen en la consola de Google Cloud , sigue estos pasos:
En la consola de Google Cloud , ve a la página Traducción de SQL.
En la lista de trabajos de traducción, busca el que te interesa y, luego, haz clic en su nombre o en Más opciones > Mostrar detalles.
En la pestaña Detalles del trabajo, en la sección Informe de traducción, haz clic en translation_report.csv.
En la página Detalles del objeto, haz clic en el valor de la fila URL autenticada para ver el archivo en tu navegador.
En la siguiente tabla, se describen las columnas de archivos de resumen:
| Columna | Descripción |
|---|---|
| Marca de tiempo | La marca de tiempo en la que ocurrió el problema. |
| FilePath | La ruta de acceso al archivo de origen con el que está asociado el problema. |
| Nombre del archivo | El nombre del archivo de origen con el que está asociado el problema. |
| ScriptLine | El número de línea en la que ocurrió el problema. |
| ScriptColumn | El número de columna en la que ocurrió el problema. |
| TranspilerComponent | El componente interno del motor de traducción en el que se produjo la advertencia o el error. Esta columna puede estar vacía. |
| Entorno | Es el entorno del dialecto de traducción asociado con la advertencia o el error. Esta columna puede estar vacía. |
| ObjectName | Es el objeto de SQL en el archivo de origen que está asociado con la advertencia o el error. Esta columna puede estar vacía. |
| Gravedad | La gravedad del problema, ya sea una advertencia o un error. |
| Categoría | La categoría del problema de traducción. |
| SourceType | Es la fuente de este problema. El valor de esta columna puede ser
SQL, que indica un problema en los archivos SQL de entrada, o
METADATA, que indica un problema en el paquete de metadatos. |
| Mensaje | El mensaje de advertencia o de error del problema de traducción. |
| ScriptContext | El fragmento de SQL en el archivo de origen que está asociado con el problema. |
| Acción | La acción que te recomendamos que realices para resolver el problema. |
Pestaña Código
La pestaña Código te permite revisar más información sobre los archivos de entrada y salida para un trabajo de traducción en particular. En la pestaña Código, puedes examinar los archivos usados en un trabajo de traducción, revisar una comparación en paralelo de un archivo de entrada y su traducción para detectar errores y ver resúmenes de registros y mensajes para un archivo específico en un trabajo.
Para acceder a la pestaña Código, sigue estos pasos:
En la consola de Google Cloud , ve a la página Traducción de SQL.
En la lista de trabajos de traducción, busca el que te interesa y, luego, haz clic en su nombre o en Más opciones > Mostrar detalles.
Seleccionar la pestaña Código. La pestaña de código consta de los siguientes paneles:
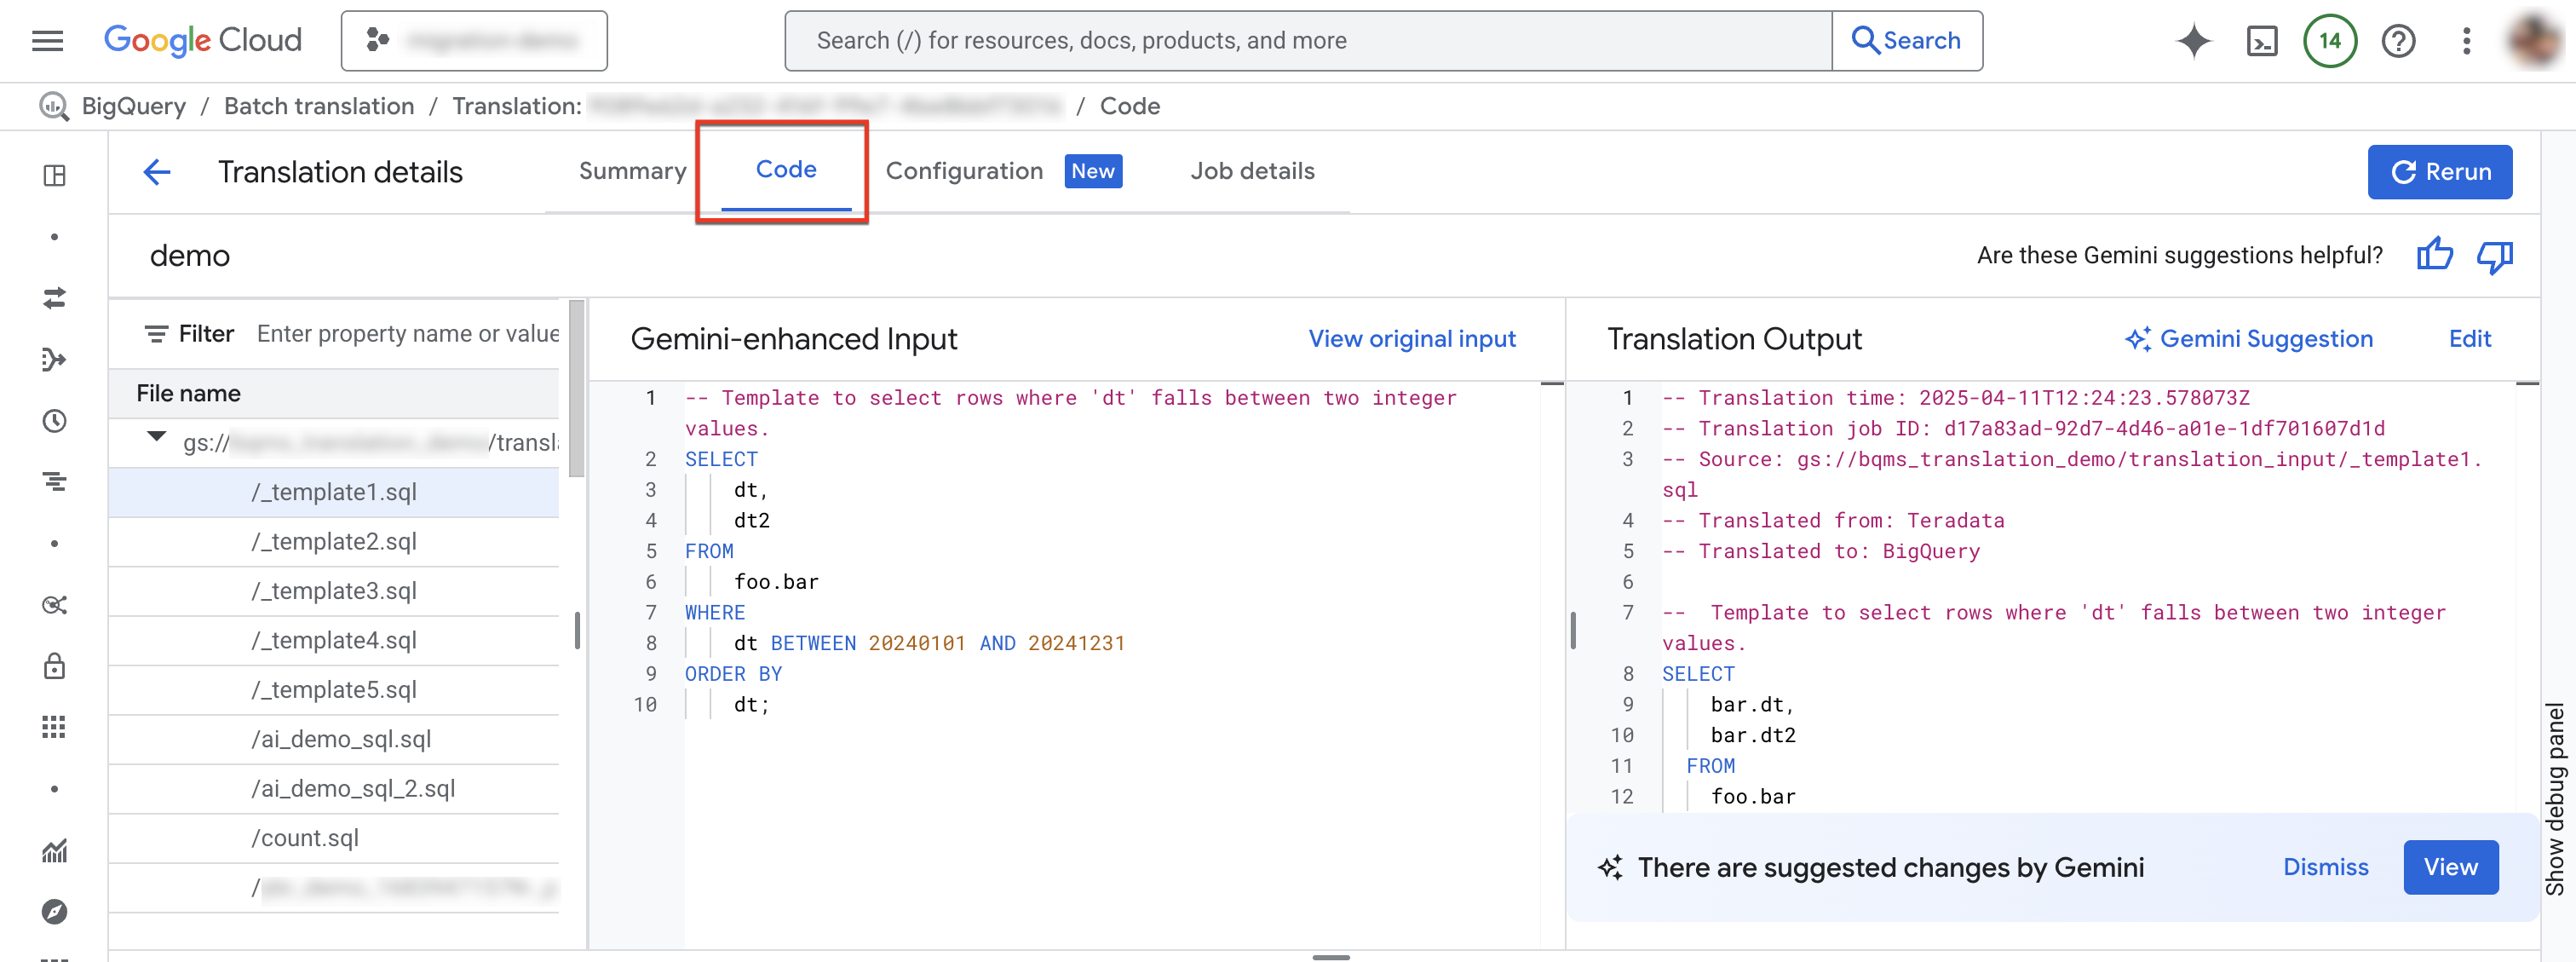
- Explorador de archivos: Contiene todos los archivos SQL que se usan para la traducción. Haz clic en un archivo para ver su entrada y salida de traducción, y cualquier problema de traducción.
- Entrada mejorada con Gemini: Es la entrada en SQL que tradujo el motor de traducción. Si especificaste reglas de personalización de Gemini para el SQL fuente en la configuración de Gemini, el traductor primero transforma la entrada original y, luego, traduce la entrada mejorada con Gemini. Para ver la entrada original, haz clic en Ver entrada original.
- Resultado de la traducción: Es el resultado de la traducción. Si especificaste reglas de personalización de Gemini para el SQL de destino en la configuración de Gemini, la transformación se aplica al resultado traducido como un resultado mejorado con Gemini. Si hay un resultado mejorado por Gemini disponible, puedes hacer clic en el botón Sugerencia de Gemini para revisarlo.
Opcional: Para ver un archivo de entrada y su archivo de salida en el traductor de SQL interactivo de BigQuery, haz clic en Editar. Puedes editar los archivos y guardar el archivo de salida en Cloud Storage.
Pestaña Configuración
Puedes agregar, cambiar el nombre, ver o editar tus archivos YAML de configuración en la pestaña Configuración. El Explorador de esquemas muestra la documentación de los tipos de configuración admitidos para ayudarte a escribir tus archivos YAML de configuración. Después de editar los archivos YAML de configuración, puedes volver a ejecutar el trabajo para usar la nueva configuración.
Para acceder a la pestaña de configuración, sigue estos pasos:
En la consola de Google Cloud , ve a la página Traducción de SQL.
En la lista de trabajos de traducción, busca el que te interesa y, luego, haz clic en su nombre o en Más opciones > Mostrar detalles.
En la ventana Detalles de la traducción, haz clic en la pestaña Configuración.

Para agregar un archivo de configuración nuevo, haz lo siguiente:
- Haz clic en more_vert Más opciones > Crear archivo YAML de configuración.
- Aparecerá un panel en el que podrás elegir el tipo, la ubicación y el nombre del nuevo archivo YAML de configuración.
- Haz clic en Crear.
Para editar un archivo de configuración existente, sigue estos pasos:
- Haz clic en el archivo YAML de configuración.
- Edita el archivo y, luego, haz clic en Guardar.
- Haz clic en Volver a ejecutar para ejecutar un nuevo trabajo de traducción que use los archivos YAML de configuración editados.
Para cambiar el nombre de un archivo de configuración existente, haz clic en more_vert Más opciones > Cambiar nombre.
Archivos traducidos
Para cada archivo de origen, se genera el archivo de salida correspondiente en la ruta de destino. El archivo de salida contiene la consulta traducida.
Cómo controlar las funciones de SQL no admitidas con UDF auxiliares
Cuando se traduce SQL de un dialecto de origen a BigQuery, es posible que algunas funciones no tengan un equivalente directo. Para abordar este problema, el Servicio de migración de BigQuery (y la comunidad más amplia de BigQuery) proporcionan funciones definidas por el usuario (UDF) auxiliares que replican el comportamiento de estas funciones de dialecto fuente no admitidas.
Estas UDF se suelen encontrar en el conjunto de datos públicos bqutil, lo que permite que las consultas traducidas hagan referencia a ellas inicialmente con el formato bqutil.<dataset>.<function>(). Por ejemplo, bqutil.fn.cw_count().
Consideraciones para entornos de producción
Si bien bqutil ofrece acceso conveniente a estas UDF auxiliares para la traducción y las pruebas iniciales, no se recomienda depender directamente de bqutil para las cargas de trabajo de producción por los siguientes motivos:
- Control de versiones: El proyecto
bqutilaloja la versión más reciente de estas UDF, lo que significa que sus definiciones pueden cambiar con el tiempo. Confiar directamente enbqutilpodría generar un comportamiento inesperado o cambios rotundos en tus consultas de producción si se actualiza la lógica de una UDF. - Aislamiento de dependencias: Implementar UDF en tu propio proyecto aísla tu entorno de producción de los cambios externos.
- Personalización: Es posible que debas modificar u optimizar estas UDF para que se adapten mejor a tu lógica empresarial específica o a tus requisitos de rendimiento. Esto solo es posible si se encuentran dentro de tu propio proyecto.
- Seguridad y administración: Es posible que las políticas de seguridad de tu organización restrinjan el acceso directo a conjuntos de datos públicos, como
bqutil, para el procesamiento de datos de producción. Copiar UDFs a tu entorno controlado se alinea con esas políticas.
Implementa UDF auxiliares en tu proyecto
Para brindarte un control total sobre la versión, la personalización y el acceso a las UDF, te recomendamos que implementes UDF auxiliares en tu propio proyecto y conjunto de datos para un uso de producción confiable y estable. Para obtener más información sobre las secuencias de comandos y los pasos necesarios para implementar UDF auxiliares en tu entorno, consulta Implementación de las UDF.
Soluciona problemas
En esta sección, se describe cómo depurar consultas individuales y cómo resolver los errores de traducción más comunes.
Depura consultas de SQL traducidas por lotes con el traductor interactivo de SQL
Puedes usar el traductor interactivo de SQL de BigQuery para revisar o depurar una consulta en SQL con los mismos metadatos o la misma información de asignación de objetos que la base de datos de origen. Después de completar un trabajo de traducción por lotes, BigQuery genera un ID de configuración de traducción que contiene información sobre los metadatos del trabajo, la asignación de objetos o la ruta de búsqueda del esquema, según corresponda para la consulta. Usa el ID de configuración de traducción por lotes con el traductor interactivo de SQL para ejecutar consultas de SQL con la configuración especificada.
Para iniciar una traducción interactiva de SQL a través de un ID de configuración de traducción por lotes, sigue estos pasos:
En la consola de Google Cloud , ve a la página Traducción de SQL.
En la lista de trabajos de traducción, busca el trabajo que te interesa y, luego, haz clic en Más opciones > Abrir la traducción interactiva.
El traductor interactivo de SQL de BigQuery ahora se abre con el ID de configuración de traducción por lotes correspondiente. Para ver el ID de configuración de traducción de la traducción interactiva, haz clic en Herramientas > Traducción de consultas > Configuración de traducción en el traductor de SQL interactivo.
Para depurar un archivo de traducción por lotes en el traductor interactivo de SQL, sigue estos pasos:
En la consola de Google Cloud , ve a la página Traducción de SQL.
En la lista de trabajos de traducción, busca el que te interesa y, luego, haz clic en su nombre o en Más opciones > Mostrar detalles.
En la ventana Detalles de la traducción, haz clic en la pestaña Código.
En el explorador de archivos, haz clic en el nombre del archivo para abrirlo.
Junto al nombre del archivo de salida, haz clic en Editar para abrir los archivos en el traductor de SQL interactivo (Vista previa).
Verás los archivos de entrada y salida completados en el traductor interactivo de SQL, que ahora usa el ID de configuración de traducción por lotes correspondiente.
Para guardar el archivo de salida editado en Cloud Storage, en el traductor interactivo de SQL, haz clic en Guardar > Guardar en GCS.
Soluciona problemas de errores de traducción
En las siguientes secciones, se describen los errores que se suelen encontrar cuando se usa el traductor de SQL por lotes.
Problemas de traducción de RelationNotFound o AttributeNotFound
Después de traducir una consulta con el traductor de SQL por lotes, es posible que se produzca un error en la traducción con el error RelationNotFound o AttributeNotFound.
Para encontrar las traducciones fallidas, ve a la página Detalles de la traducción en BigQuery en la consola de Google Cloud y abre la pestaña Mensajes de registro.
La traducción funciona mejor con DDL de metadatos. Cuando no se pueden encontrar definiciones de objetos SQL, el motor de traducción genera problemas RelationNotFound o AttributeNotFound. Recomendamos usar el extractor de metadatos para generar paquetes de metadatos para garantizar que todas las definiciones de objetos estén presentes. Agregar metadatos es el primer paso recomendado para resolver la mayoría de los errores de traducción, ya que a menudo corrige muchos otros errores que se generan de forma indirecta por la falta de metadatos.
Si deseas obtener más información, consulta Genera metadatos para la traducción y la evaluación.
Cómo corregir problemas de traducción con Gemini
Para corregir los trabajos de traducción fallidos con los errores RelationNotFound o AttributeNotFound, también puedes usar Gemini para resolver estos problemas:
- Ve a la página Detalles de la traducción y abre la pestaña Mensajes de registro.
- Haz clic en la búsqueda que tenga el mensaje
RelationNotFoundoAttributeNotFounden la columna Categoría. Para ir al archivo y a la línea que contienen el error en la pestaña de código, haz clic en el
mensaje de error.
En la columna Acción, haz clic en Sugerencia de corrección.
Selecciona una de las siguientes opciones: Aplicar o Aplicar y volver a ejecutar.
- Para copiar el archivo de esquema generado del directorio de salida al directorio de entrada, haz clic en Aplicar.
- Para copiar el archivo de esquema generado del directorio de salida al directorio de entrada y abrir una ventana de nueva ejecución, haz clic en Aplicar y volver a ejecutar.
Cuota y límites
- Se aplican las cuotas de la API de BigQuery Migration.
- Cada proyecto puede tener como máximo 10 tareas de traducción activas.
- Si bien no existe un límite estricto en la cantidad total de archivos de origen y de metadatos, recomendamos mantener la cantidad de archivos por debajo de 1,000 para obtener un mejor rendimiento.
Precios
No se aplican cargos por usar el traductor de SQL por lotes. Sin embargo, se aplican las tarifas normales al almacenamiento que se usa para almacenar archivos de entrada y salida. Para obtener más información, consulta los precios de almacenamiento.
¿Qué sigue?
Obtén más información sobre los siguientes pasos en la migración de almacenes de datos:
- Descripción general de la migración
- Evaluación de la migración
- Descripción general de transferencia de datos y esquemas
- Canalizaciones de datos
- Traducción de SQL interactiva
- Seguridad y administración de los datos
- Herramienta de validación de datos